
O que é Geração Aumentada por Recuperação? Como o RAG torna a IA mais inteligente e confiável
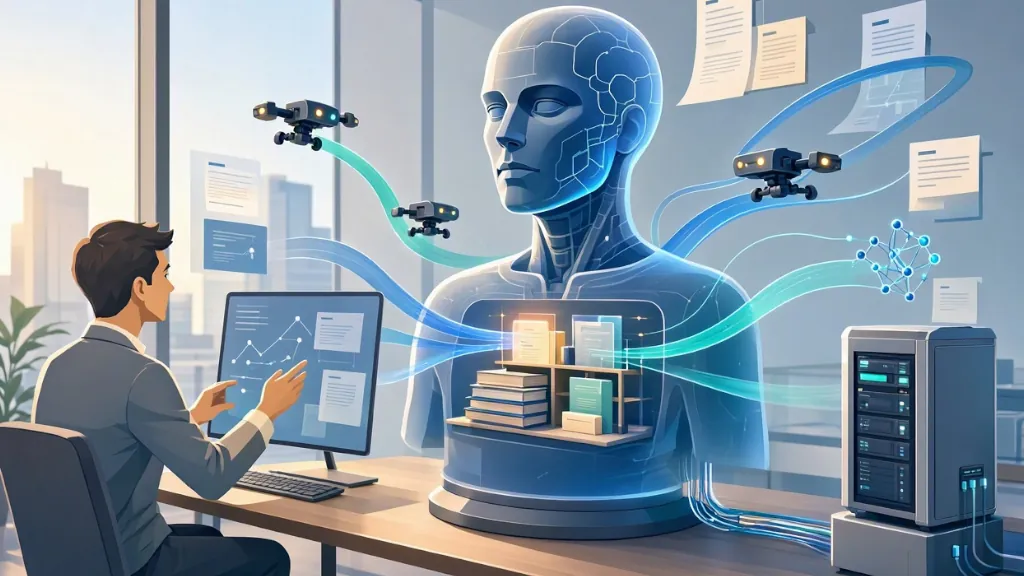
Imagine fazer a um professor brilhante uma pergunta sobre as notícias locais de ontem, apenas para vê-lo inventar com total confiança uma mentira altamente plausível porque sua biblioteca não é atualizada há anos. Esse é exatamente o desafio que enfrentamos com os Grandes Modelos de Linguagem (LLMs) modernos. Embora esses sistemas de IA sejam incrivelmente articulados, seu conhecimento fica completamente congelado no tempo no momento em que seu treinamento termina. Quando você pergunta sobre eventos recentes ou tópicos de nicho, eles tendem a "alucinar" — inventando fatos incorretos com absoluta confiança.
Para corrigir essa limitação frustrante, pesquisadores de IA desenvolveram uma solução inteligente chamada Geração Aumentada por Recuperação, ou RAG (Retrieval-Augmented Generation). Em de vez de forçar a IA a confiar apenas no que ela já sabe, o RAG permite que ela consulte informações externas em tempo real antes de redigir uma resposta. Pense nisso como uma prova com consulta para a inteligência artificial. Isso garante que as respostas obtidas sejam precisas, atualizadas e realmente verificáveis. Vamos entender como o RAG funciona, por que ele é um divisor de águas e como está reformulando completamente nossa relação com a tecnologia.
O que é Geração Aumentada por Recuperação (RAG) e por que ela é importante?
Em sua essência, a Geração Aumentada por Recuperação é uma arquitetura de IA que aprimora o que um Grande Modelo de Linguagem diz, permitindo que ele consulte um banco de dados externo e confiável, fora de seus dados de treinamento originais. Apresentado pela primeira vez por pesquisadores da Meta AI em 2020, o RAG preenche a lacuna entre os modelos de IA estáticos e congelados e o nosso mundo dinâmico e em constante mudança. Basicamente, ele combina as habilidades de escrita fluidas e conversacionais de um LLM com a precisão cirúrgica de um mecanismo de busca.
Para entender de verdade como o RAG funciona, vamos analisar os dois tipos diferentes de memória que um sistema de IA pode utilizar:
- Memória Paramétrica: Este é o conhecimento embutido que a IA adquiriu durante seu treinamento inicial, guardado profundamente em sua rede neural. É incrivelmente difícil e caro de atualizar depois de definido.
- Memória Não Paramétrica: Pense nisso como o disco rígido externo da IA. Inclui documentos, bancos de dados em tempo real ou sites que a IA pode pesquisar sob demanda. Você pode atualizar isso instantaneamente sem precisar retreinar o próprio modelo.
Ao misturar esses dois tipos de memória, o RAG garante que a IA não precise memorizar a internet inteira. Em vez disso, o modelo simplesmente aprende a ler, compreender e resumir as informações fornecidas a ele em tempo real, oferecendo respostas incrivelmente precisas e conscientes do contexto.
Como o RAG funciona: um guia passo a passo do processo de recuperação
A verdadeira magia do RAG está em seu fluxo de trabalho, que conecta perfeitamente sua pergunta a um banco de dados externo e de volta à IA em milissegundos. Todo o processo é dividido em quatro fases principais: ingestão, recuperação, aumento e geração.
Passo 1: Ingestão de dados e transformação de palavras em matemática (vetorização)
Antes que um sistema RAG possa responder a qualquer pergunta, ele precisa construir sua biblioteca. Ele pega dados brutos — como PDFs, artigos ou manuais da empresa — e os divide em pedaços menores e fáceis de processar, chamados de "chunks" (fragmentos). Em seguida, um modelo de incorporação (embedding) converte esses fragmentos em representações matemáticas conhecidas como "vetores de incorporação" (vector embeddings).
Esses embeddings capturam o significado real do texto, posicionando conceitos semelhantes próximos uns dos outros em um mapa multidimensional. Por fim, esses vetores são salvos em um sistema especializado chamado banco de dados vetorial (vector database), aguardando para serem pesquisados a qualquer momento.
Passo 2: A fase de recuperação (encontrando a informação certa)
Quando você faz uma pergunta, o sistema RAG não a envia diretamente para o LLM. Primeiro, ele converte sua consulta em um vetor usando exatamente o mesmo modelo de embedding. Em seguida, ele pesquisa no banco de dados vetorial para encontrar os fragmentos de texto que estão matematicamente mais próximos em significado ao que você perguntou.
Chamamos esse processo de busca semântica. Ao contrário das buscas por palavras-chave tradicionais, que procuram apenas correspondências exatas de palavras, a busca semântica realmente entende a intenção e o contexto por trás da sua pergunta. Isso significa que ela pode trazer documentos altamente relevantes, mesmo que eles usem palavras completamente diferentes.
Passo 3: A fase de aumento (preparando a "cola" da IA)
Assim que o sistema obtém os fragmentos mais relevantes, ele os mescla com a sua pergunta original. É aqui que acontece a parte do "aumento". O sistema cria um novo prompt enriquecido que basicamente diz ao LLM: "Aqui estão as informações de contexto de que você precisa. Com base nesses materiais de referência, responda à pergunta do usuário."
Ao estruturar o prompt dessa forma, a IA recebe os fatos, números e contextos exatos de que precisa para construir uma resposta precisa. Isso elimina completamente a necessidade de o modelo adivinhar ou recorrer a dados de treinamento desatualizados.
Passo 4: A fase de geração (elaborando a resposta perfeita)
Por fim, o sistema envia esse prompt aprimorado para o LLM. A IA lê o contexto, extrai as informações principais e elabora uma resposta com tom natural. Como o modelo está fundamentado em documentos reais fornecidos, a resposta final é altamente precisa, adaptada à sua consulta e livre daquelas alucinações irritantes.
Os maiores benefícios de implementar o RAG para IA corporativa
O uso de uma arquitetura RAG oferece grandes vantagens em relação aos modelos de IA padrão e isolados. Ele resolve diretamente alguns dos maiores problemas que as empresas enfrentam ao implantar IA, tornando a tecnologia muito mais segura e confiável para o uso diário.
- Diga adeus às alucinações: Ao fundamentar as respostas da IA em documentos de origem verificados, o RAG reduz drasticamente as chances de o modelo inventar fatos ou números.
- Atualizações de conhecimento em tempo real: Atualizar o que sua IA sabe é tão simples quanto adicionar, excluir ou atualizar arquivos em seu banco de dados. Não é necessário nenhum retreinamento de modelo caro e demorado.
- Incrível custo-benefício: Criar ou ajustar (fine-tuning) um LLM do zero exige um enorme poder computacional e altos investimentos. O RAG oferece uma precisão incrível por uma fração do custo, combinando modelos prontos para uso com seus próprios dados.
- Rastreabilidade clara das fontes: Os sistemas RAG podem citar facilmente os documentos, páginas ou parágrafos exatos que usaram para responder à sua pergunta, permitindo que você mesmo verifique os fatos.
- Melhor privacidade de dados e controle de acesso: Você pode controlar facilmente quais documentos a IA pode acessar com base nas permissões do usuário, mantendo informações confidenciais ou sensíveis protegidas com segurança.
As limitações e desafios de construir um sistema RAG
Por mais poderoso que o RAG seja, ele não é uma solução mágica para tudo. Configurar e manter uma estrutura de RAG traz seus próprios desafios técnicos que as equipes de desenvolvimento precisam gerenciar com cuidado.
Qualidade dos dados: o dilema do "lixo entra, lixo sai"
Seu sistema RAG é tão inteligente quanto os dados que você fornece a ele. Se o seu banco de dados vetorial estiver cheio de documentos desatualizados, desorganizados ou contraditórios, sua IA fornecerá respostas confusas. Manter sua base de conhecimento limpa e organizada é um trabalho contínuo e prático.
Latência do sistema: a relação entre velocidade e precisão
Como o RAG adiciona etapas extras — converter a consulta, pesquisar no banco de dados e construir o prompt —, ele pode desacelerar o processo. Se você não otimizar o sistema, os usuários podem notar um atraso frustrante entre pressionar "Enter" e receber uma resposta.
A complexidade da fragmentação de texto e do embedding vetorial
Descobrir como fatiar documentos em fragmentos (chunks) é um desafio de engenharia surpreendentemente complexo. Se os fragmentos forem muito pequenos, você perde o contexto vital. Se forem muito grandes, corre o risco de poluir o prompt com dados irrelevantes, o que pode confundir o LLM e levar a respostas imprecisas.
Casos de uso no mundo real: como as empresas estão usando o RAG hoje
O RAG está se tornando rapidamente a arquitetura padrão para aplicações de IA no mundo real em quase todos os setores. Ao conectar a IA conversacional diretamente a dados privados e proprietários, as empresas estão alcançando aumentos massivos de produtividade.
Pegue o atendimento ao cliente, por exemplo: chatbots equipados com RAG podem escanear instantaneamente manuais de produtos e FAQs atualizados para resolver problemas complexos dos usuários na hora. No direito e na medicina, assistentes inteligentes usam o RAG para analisar milhares de arquivos de processos ou estudos clínicos, resumindo precedentes e pesquisas importantes em segundos. Além disso, as empresas estão usando o RAG internamente, permitindo que os funcionários façam buscas em enormes intranets corporativas apenas fazendo uma pergunta simples.
O futuro da IA: por que o RAG veio para ficar
A Geração Aumentada por Recuperação é um enorme salto qualitativo para tornar a IA prática, confiável e realmente digna de confiança. Ao misturar as habilidades de conversação fluidas dos LLMs com os fatos concretos de bancos de dados dedicados, o RAG resolve duas das maiores dores de cabeça da IA: alucinações e informações desatualizadas. À medida que os desenvolvedores continuam a refinar a tecnologia de busca e recuperação, o RAG permanecerá na vanguarda absoluta da revolução da IA, mudando completamente a forma como encontramos e usamos a informação.
Perguntas frequentes sobre Geração Aumentada por Recuperação (RAG)
O que significa a sigla RAG no mundo da IA?
RAG significa Retrieval-Augmented Generation (Geração Aumentada por Recuperação). É uma arquitetura de IA que extrai fatos relevantes de um banco de dados externo para ajudar um modelo de linguagem a redigir respostas mais precisas e atualizadas.
Qual é a diferença entre RAG e ajuste fino (fine-tuning)?
Pense no ajuste fino (fine-tuning) como enviar a IA para a pós-graduação — ele realmente retreina o modelo com novos dados para mudar a forma como ele pensa, o que é lento e caro. O RAG, por outro lado, é como dar à IA um livro aberto durante uma prova. Ele não altera o modelo em si; apenas entrega a ele os documentos certos para ler antes de responder.
O RAG impede completamente as alucinações de IA?
Não totalmente, mas ajuda muito. Embora o RAG reduza drasticamente as alucinações ao ancorar a IA em documentos reais e fatos concretos, as coisas ainda podem dar errado. Se os documentos de origem forem confusos ou se a IA interpretar mal o contexto, ela ainda poderá cometer erros.
Um sistema RAG requer uma conexão ativa com a internet?
Não necessariamente! Embora você possa configurar o RAG para pesquisar na web em tempo real, ele é mais comumente usado para pesquisar bancos de dados privados e offline, além de arquivos internos da empresa protegidos com segurança em uma rede privada.
Referências principais e leituras complementares sobre RAG
- Lewis, P., et al. (2020). "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks." NeurIPS.
- Pinecone. "O que é Geração Aumentada por Recuperação (RAG)?" Pinecone Learning Center.
- IBM Research. "O que é geração aumentada por recuperação?" IBM Technology Guides.


Comentários
Postar um comentário